@@ -248,14 +248,15 @@ mysqldump -uroot -p2143 -T /tmp test city |
248 | 248 | 命令行方式: |
249 | 249 |
|
250 | 250 | * 备份命令:mysqldump -u root -p 数据库名称 > 文件保存路径 |
251 | | - |
252 | 251 | * 恢复 |
253 | 252 | 1. 登录MySQL数据库:`mysql -u root p` |
254 | 253 | 2. 删除已经备份的数据库 |
255 | 254 | 3. 重新创建与备份数据库名称相同的数据库 |
256 | 255 | 4. 使用该数据库 |
257 | 256 | 5. 导入文件执行:`source 备份文件全路径` |
258 | 257 |
|
| 258 | +更多方式参考:https://time.geekbang.org/column/article/81925 |
| 259 | + |
259 | 260 | 图形化界面: |
260 | 261 |
|
261 | 262 | * 备份 |
@@ -386,6 +387,24 @@ MySQL 服务器可以同时和多个客户端进行交互,所以要保证每 |
386 | 387 |
|
387 | 388 |
|
388 | 389 |
|
| 390 | +*** |
| 391 | + |
| 392 | + |
| 393 | + |
| 394 | +#### 权限信息 |
| 395 | + |
| 396 | +grant 语句会同时修改数据表和内存,判断权限的时候使用的是内存数据 |
| 397 | + |
| 398 | +flush privileges 语句本身会用数据表(磁盘)的数据重建一份内存权限数据,所以在权限数据可能存在不一致的情况下使用,这种不一致往往是由于直接用 DML 语句操作系统权限表导致的,所以尽量不要使用这类语句 |
| 399 | + |
| 400 | +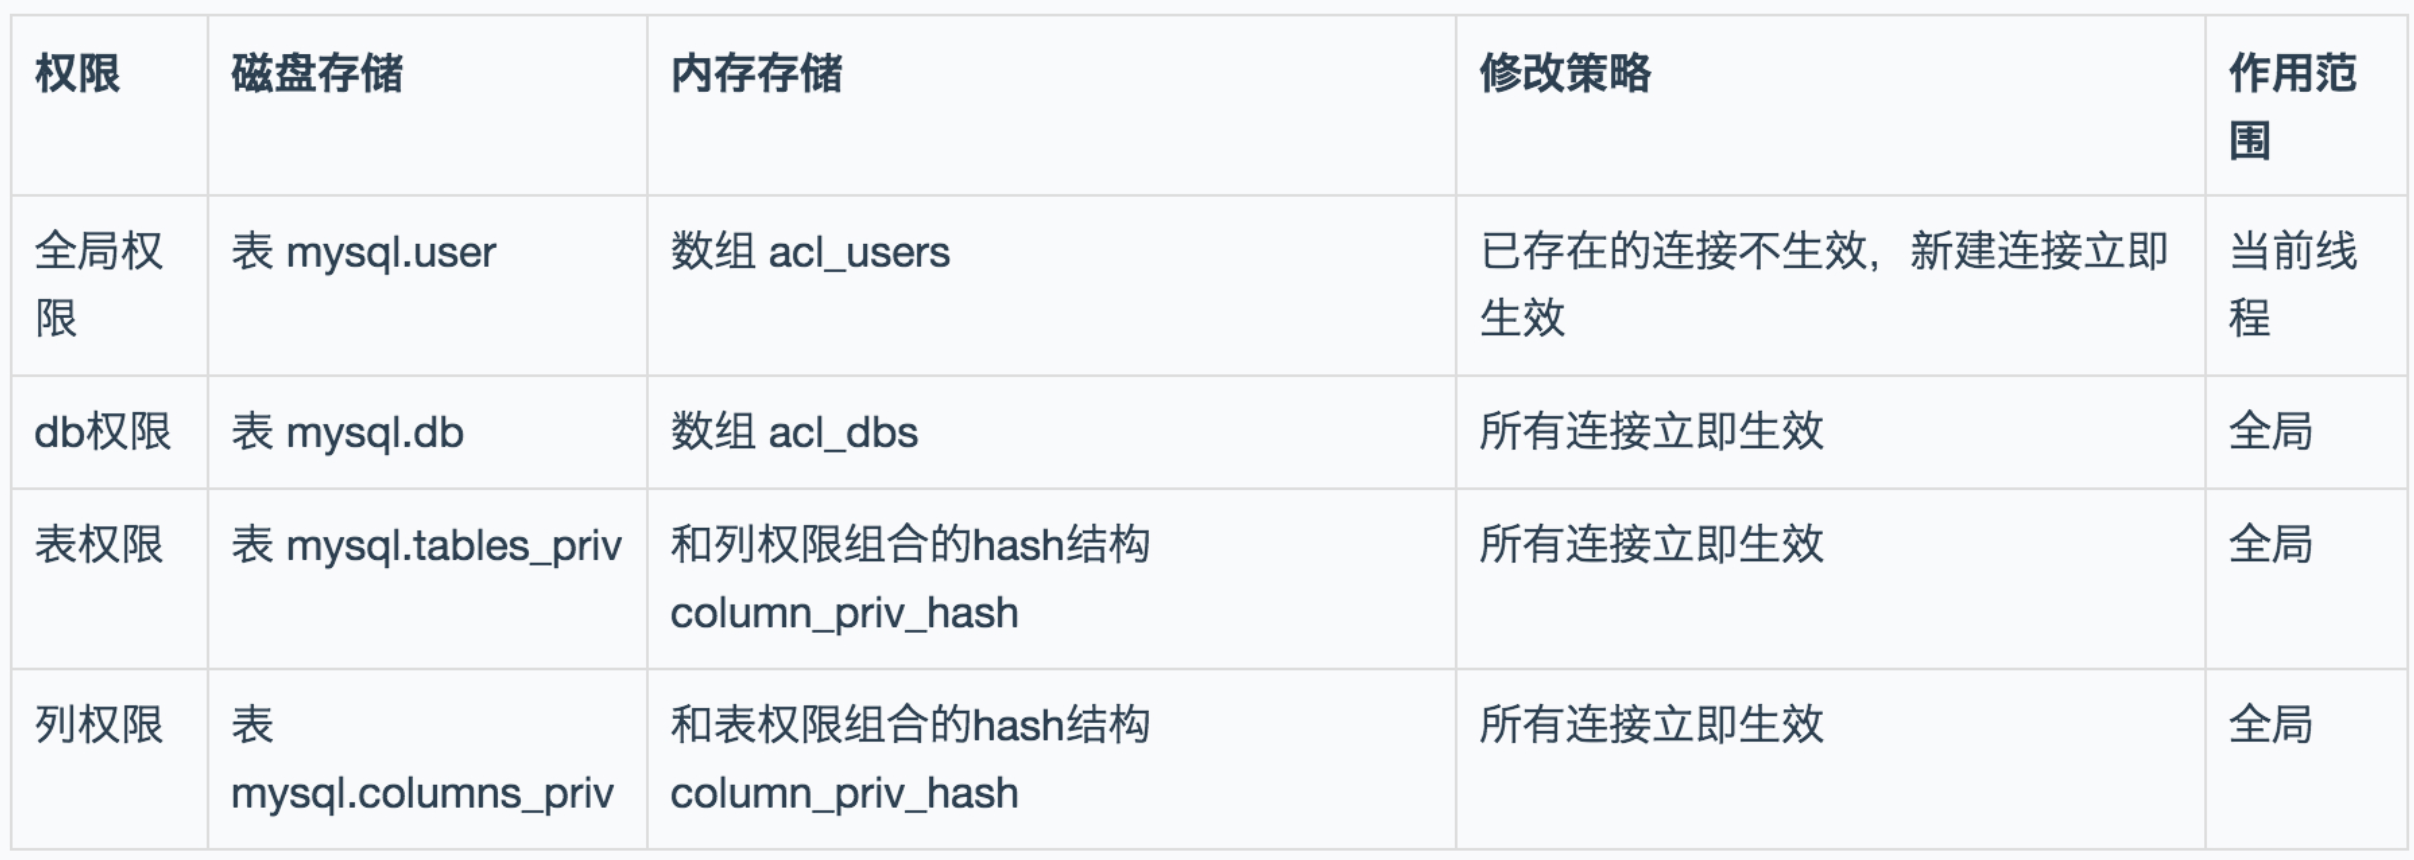 |
| 401 | + |
| 402 | + |
| 403 | + |
| 404 | + |
| 405 | + |
| 406 | + |
| 407 | + |
389 | 408 | **** |
390 | 409 |
|
391 | 410 |
|
@@ -762,7 +781,7 @@ KILL CONNECTION id |
762 | 781 | - 可使用空格和缩进来增强语句的可读性。 |
763 | 782 | - MySQL 数据库的 SQL 语句不区分大小写,**关键字建议使用大写**。 |
764 | 783 | - 数据库的注释: |
765 | | - - 单行注释:-- 注释内容 #注释内容(mysql特有) |
| 784 | + - 单行注释:-- 注释内容 #注释内容(MySQL 特有) |
766 | 785 | - 多行注释:/* 注释内容 */ |
767 | 786 |
|
768 | 787 | - SQL 分类 |
@@ -3573,7 +3592,7 @@ InnoDB 存储引擎:(MySQL5.5 版本后默认的存储引擎) |
3573 | 3592 |
|
3574 | 3593 | MEMORY 存储引擎: |
3575 | 3594 |
|
3576 | | -- 特点:每个 MEMORY 表实际对应一个磁盘文件 ,该文件中只存储表的结构,表数据保存在内存中,且默认**使用 HASH 索引**,这样有利于数据的快速处理,在需要快速定位记录可以提供更快的访问,但是**服务一旦关闭,表中的数据就会丢失**,存储不安全 |
| 3595 | +- 特点:每个 MEMORY 表实际对应一个磁盘文件 ,该文件中只存储表的结构,表数据保存在内存中,且默认**使用 HASH 索引**,所以数据默认就是无序的,但是在需要快速定位记录可以提供更快的访问,**服务一旦关闭,表中的数据就会丢失**,存储不安全 |
3577 | 3596 | - 应用场景:通常用于更新不太频繁的小表,用以快速得到访问结果,类似缓存 |
3578 | 3597 | - 存储方式:表结构保存在 .frm 中 |
3579 | 3598 |
|
@@ -3610,7 +3629,7 @@ MERGE 存储引擎: |
3610 | 3629 | | 存储限制 | 有(平台对文件系统大小的限制) | 64TB | 有(平台的内存限制) | |
3611 | 3630 | | **事务安全** | **不支持** | **支持** | **不支持** | |
3612 | 3631 | | **锁机制** | **表锁** | **表锁/行锁** | **表锁** | |
3613 | | -| B+Tree索引 | 支持 | 支持 | 支持 | |
| 3632 | +| B+Tree 索引 | 支持 | 支持 | 支持 | |
3614 | 3633 | | 哈希索引 | 不支持 | 不支持 | 支持 | |
3615 | 3634 | | 全文索引 | 支持 | 支持 | 不支持 | |
3616 | 3635 | | 集群索引 | 不支持 | 支持 | 不支持 | |
@@ -4120,7 +4139,7 @@ B+ 树为了保持索引的有序性,在插入新值的时候需要做相应 |
4120 | 4139 |
|
4121 | 4140 | 一般选用数据小的字段做索引,字段长度越小,普通索引的叶子节点就越小,普通索引占用的空间也就越小 |
4122 | 4141 |
|
4123 | | -自增主键的插入数据模式,不涉及到挪动其他记录,也**不会触发叶子节点的分裂** |
| 4142 | +自增主键的插入数据模式,可以让主键索引尽量地保持递增顺序插入,不涉及到挪动其他记录,**避免了页分裂** |
4124 | 4143 |
|
4125 | 4144 |
|
4126 | 4145 |
|
@@ -4340,8 +4359,110 @@ CREATE INDEX idx_area ON table_name(area(7)); |
4340 | 4359 |
|
4341 | 4360 | ### 表优化 |
4342 | 4361 |
|
| 4362 | +#### 分区表 |
| 4363 | + |
| 4364 | +##### 基本介绍 |
| 4365 | + |
| 4366 | +分区表是将大表的数据按分区字段分成许多小的子集,建立一个以 ftime 年份为分区的表: |
| 4367 | + |
| 4368 | +```mysql |
| 4369 | +CREATE TABLE `t` ( |
| 4370 | + `ftime` datetime NOT NULL, |
| 4371 | + `c` int(11) DEFAULT NULL, |
| 4372 | + KEY (`ftime`) |
| 4373 | +) ENGINE=InnoDB DEFAULT CHARSET=latin1 |
| 4374 | +PARTITION BY RANGE (YEAR(ftime)) |
| 4375 | +(PARTITION p_2017 VALUES LESS THAN (2017) ENGINE = InnoDB, |
| 4376 | + PARTITION p_2018 VALUES LESS THAN (2018) ENGINE = InnoDB, |
| 4377 | + PARTITION p_2019 VALUES LESS THAN (2019) ENGINE = InnoDB, |
| 4378 | + PARTITION p_others VALUES LESS THAN MAXVALUE ENGINE = InnoDB); |
| 4379 | +INSERT INTO t VALUES('2017-4-1',1),('2018-4-1',1);-- 这两行记录分别落在 p_2018 和 p_2019 这两个分区上 |
| 4380 | +``` |
| 4381 | + |
| 4382 | +这个表包含了一个.frm 文件和 4 个.ibd 文件,每个分区对应一个.ibd 文件 |
| 4383 | + |
| 4384 | +* 对于引擎层来说,这是 4 个表,针对每个分区表的操作不会相互影响 |
| 4385 | +* 对于 Server 层来说,这是 1 个表 |
| 4386 | + |
| 4387 | + |
| 4388 | + |
| 4389 | +*** |
| 4390 | + |
| 4391 | + |
| 4392 | + |
| 4393 | +##### 分区策略 |
| 4394 | + |
| 4395 | +打开表行为:第一次访问一个分区表时,MySQL 需要**把所有的分区都访问一遍**,如果分区表的数量很多,超过了 open_files_limit 参数(默认值 1024),那么就会在访问这个表时打开所有的文件,导致打开表文件的个数超过了上限而报错 |
| 4396 | + |
| 4397 | +通用分区策略:MyISAM 分区表使用的分区策略,每次访问分区都由 Server 层控制,在文件管理、表管理的实现上很粗糙,因此有比较严重的性能问题 |
| 4398 | + |
| 4399 | +本地分区策略:从 MySQL 5.7.9 开始,InnoDB 引擎内部自己管理打开分区的行为,InnoDB 引擎打开文件超过 innodb_open_files 时就会**关掉一些之前打开的文件**,所以即使分区个数大于 open_files_limit,也不会报错 |
| 4400 | + |
| 4401 | +从 MySQL 8.0 版本开始,就不允许创建 MyISAM 分区表,只允许创建已经实现了本地分区策略的引擎,目前只有 InnoDB 和 NDB 这两个引擎支持了本地分区策略 |
| 4402 | + |
| 4403 | + |
| 4404 | + |
| 4405 | +*** |
| 4406 | + |
| 4407 | + |
| 4408 | + |
| 4409 | +##### Server 层 |
| 4410 | + |
| 4411 | +从 Server 层看一个分区表就只是一个表 |
| 4412 | + |
| 4413 | +* Session A: |
| 4414 | + |
| 4415 | + ```mysql |
| 4416 | + SELECT * FROM t WHERE ftime = '2018-4-1'; |
| 4417 | + ``` |
| 4418 | + |
| 4419 | +* Session B: |
| 4420 | + |
| 4421 | + ```mysql |
| 4422 | + ALTER TABLE t TRUNCATE PARTITION p_2017; -- blocked |
| 4423 | + ``` |
| 4424 | + |
| 4425 | +现象:Session B 只操作 p_2017 分区,但是由于 Session A 持有整个表 t 的 MDL 读锁,就导致 B 的 ALTER 语句获取 MDL 写锁阻塞 |
| 4426 | + |
| 4427 | +分区表的特点: |
| 4428 | + |
| 4429 | +* 一个是第一次访问的时候需要访问所有分区 |
| 4430 | +* 在 Server 层认为这是同一张表,因此所有分区共用同一个 MDL 锁 |
| 4431 | +* 在引擎层认为这是不同的表,因此 MDL 锁之后的执行过程,会根据分区表规则,只访问需要的分区 |
| 4432 | + |
| 4433 | + |
| 4434 | + |
| 4435 | +*** |
| 4436 | + |
| 4437 | + |
| 4438 | + |
| 4439 | +##### 应用场景 |
| 4440 | + |
| 4441 | +分区表的优点: |
| 4442 | + |
| 4443 | +* 对业务透明,相对于用户分表来说,使用分区表的业务代码更简洁。 |
| 4444 | + |
| 4445 | +* 分区表可以很方便的清理历史数据。按照时间分区的分区表,就可以直接通过 `alter table t drop partition` 这个语法直接删除分区文件,从而删掉过期的历史数据,与使用 drop 语句删除数据相比,优势是速度快、对系统影响小 |
| 4446 | + |
| 4447 | +使用分区表,不建议创建太多的分区,注意事项: |
| 4448 | + |
| 4449 | +* 分区并不是越细越好,单表或者单分区的数据一千万行,只要没有特别大的索引,对于现在的硬件能力来说都已经是小表 |
| 4450 | +* 分区不要提前预留太多,在使用之前预先创建即可。比如是按月分区,每年年底时再把下一年度的 12 个新分区创建上即可,并且对于没有数据的历史分区,要及时的 drop 掉。 |
| 4451 | + |
| 4452 | + |
| 4453 | + |
| 4454 | +参考文档:https://time.geekbang.org/column/article/82560 |
| 4455 | + |
| 4456 | + |
| 4457 | + |
| 4458 | +*** |
| 4459 | + |
| 4460 | + |
| 4461 | + |
4343 | 4462 | #### 临时表 |
4344 | 4463 |
|
| 4464 | +##### 基本介绍 |
| 4465 | + |
4345 | 4466 | 临时表分为内部临时表和用户临时表 |
4346 | 4467 |
|
4347 | 4468 | * 内部临时表:系统执行 SQL 语句优化时产生的表,例如 Join 连接查询、去重查询等 |
@@ -4370,7 +4491,7 @@ CREATE INDEX idx_area ON table_name(area(7)); |
4370 | 4491 |
|
4371 | 4492 |
|
4372 | 4493 |
|
4373 | | -#### 重名原理 |
| 4494 | +##### 重名原理 |
4374 | 4495 |
|
4375 | 4496 | 执行创建临时表的 SQL: |
4376 | 4497 |
|
@@ -4395,8 +4516,6 @@ MySQL 维护数据表,除了物理磁盘上的文件外,内存里也有一 |
4395 | 4516 |
|
4396 | 4517 |
|
4397 | 4518 |
|
4398 | | -#### 基本应用 |
4399 | | - |
4400 | 4519 | ##### 主备复制 |
4401 | 4520 |
|
4402 | 4521 | 创建临时表的语句会传到备库执行,因此备库的同步线程就会创建这个临时表。主库在线程退出时会自动删除临时表,但备库同步线程是持续在运行的并不会退出,所以这时就需要在主库上再写一个 DROP TEMPORARY TABLE 传给备库执行 |
@@ -5079,6 +5198,66 @@ SHOW GLOBAL STATUS LIKE 'Handler_read%'; |
5079 | 5198 |
|
5080 | 5199 | ### SQL 优化 |
5081 | 5200 |
|
| 5201 | +#### 自增主键 |
| 5202 | + |
| 5203 | +##### 自增机制 |
| 5204 | + |
| 5205 | +自增主键可以让主键索引尽量地保持递增顺序插入,避免了页分裂,因此索引更紧凑 |
| 5206 | + |
| 5207 | +表的结构定义存放在后缀名为.frm 的文件中,但是并不会保存自增值,不同的引擎对于自增值的保存策略不同: |
| 5208 | + |
| 5209 | +* MyISAM 引擎的自增值保存在数据文件中 |
| 5210 | +* InnoDB 引擎的自增值保存在了内存里,每次打开表都会去找自增值的最大值 max(id),然后将 max(id)+1 作为当前的自增值;8.0 版本后,才有了自增值持久化的能力,将自增值的变更记录在了 redo log 中,重启的时候依靠 redo log 恢复重启之前的值 |
| 5211 | + |
| 5212 | +在插入一行数据的时候,自增值的行为如下: |
| 5213 | + |
| 5214 | +* 如果插入数据时 id 字段指定为 0、null 或未指定值,那么就把这个表当前的 AUTO_INCREMENT 值填到自增字段 |
| 5215 | +* 如果插入数据时 id 字段指定了具体的值,比如某次要插入的值是 X,当前的自增值是 Y |
| 5216 | + * 如果 X<Y,那么这个表的自增值不变 |
| 5217 | + * 如果 X≥Y,就需要把当前自增值修改为新的自增值 |
| 5218 | + |
| 5219 | +参数说明:auto_increment_offset 和 auto_increment_increment 分别表示自增的初始值和步长,默认值都是 1 |
| 5220 | + |
| 5221 | +语句执行失败也不回退自增 id,所以保证了自增 id 是递增的,但不保证是连续的(不能回退,所以有些回滚事务的自增 id 就不会重新使用,导致出现不连续) |
| 5222 | + |
| 5223 | + |
| 5224 | + |
| 5225 | +**** |
| 5226 | + |
| 5227 | + |
| 5228 | + |
| 5229 | +##### 自增 ID |
| 5230 | + |
| 5231 | +MySQL 不同的自增 id 在达到上限后的表现不同: |
| 5232 | + |
| 5233 | +* 表的自增 id 如果是 int 类型,达到上限 2^32-1 后,再申请时值就不会改变,进而导致继续插入数据时报主键冲突的错误 |
| 5234 | + |
| 5235 | +* row_id 长度为 6 个字节,达到上限后则会归 0 再重新递增,如果出现相同的 row_id,后写的数据会覆盖之前的数据,造成旧数据丢失,影响的是数据可靠性,所以应该在 InnoDB 表中主动创建自增主键报主键冲突,插入失败影响的是可用性,而一般情况下,**可靠性优先于可用性** |
| 5236 | + |
| 5237 | +* Xid 长度 8 字节,由 Server 层维护,只需要不在同一个 binlog 文件中出现重复值即可,虽然理论上会出现重复值,但是概率极小 |
| 5238 | + |
| 5239 | +* InnoDB 的 max_trx_id 递增值每次 MySQL 重启都会被保存起来,重启也不会重置为 0,所以会导致一直增加到达上限,然后从 0 开始,这时原事务 0 修改的数据对当前事务就是可见的,产生脏读的现象 |
| 5240 | + |
| 5241 | + 只读事务不分配 trx_id,所以 trx_id 的增加速度变慢了 |
| 5242 | + |
| 5243 | +* thread_id 长度 4 个字节,到达上限后就会重置为 0,MySQL 设计了一个唯一数组的逻辑,给新线程分配 thread_id 时做判断,保证不会出现两个相同的 thread_id: |
| 5244 | + |
| 5245 | + ```c++ |
| 5246 | + do { |
| 5247 | + new_id = thread_id_counter++; |
| 5248 | + } while (!thread_ids.insert_unique(new_id).second); |
| 5249 | + ``` |
| 5250 | +
|
| 5251 | +
|
| 5252 | +
|
| 5253 | +参考文章:https://time.geekbang.org/column/article/83183 |
| 5254 | +
|
| 5255 | +
|
| 5256 | +
|
| 5257 | +*** |
| 5258 | +
|
| 5259 | +
|
| 5260 | +
|
5082 | 5261 | #### 覆盖索引 |
5083 | 5262 |
|
5084 | 5263 | 复合索引叶子节点不仅保存了复合索引的值,还有主键索引,所以使用覆盖索引的时候,加上主键也会用到索引 |
@@ -5166,9 +5345,9 @@ LOAD DATA LOCAL INFILE = '/home/seazean/sql1.log' INTO TABLE `tb_user_1` FIELD T |
5166 | 5345 |
|
5167 | 5346 | 对于 InnoDB 类型的表,有以下几种方式可以提高导入的效率: |
5168 | 5347 |
|
5169 | | -1. **主键顺序插入**:因为 InnoDB 类型的表是按照主键的顺序保存的,所以将导入的数据按照主键的顺序排列,可以有效的提高导入数据的效率,如果 InnoDB 表没有主键,那么系统会自动默认创建一个内部列作为主键。 |
| 5348 | +1. **主键顺序插入**:因为 InnoDB 类型的表是按照主键的顺序保存的,所以将导入的数据按照主键的顺序排列,可以有效的提高导入数据的效率,如果 InnoDB 表没有主键,那么系统会自动默认创建一个内部列作为主键 |
5170 | 5349 |
|
5171 | | - **主键是否连续对性能影响不大,只要是递增的就可以**,比如雪花算法产生的 ID 不是连续的,但是是递增的 |
| 5350 | + 主键是否连续对性能影响不大,只要是递增的就可以,比如雪花算法产生的 ID 不是连续的,但是是递增的,因为递增可以让主键索引尽量地保持顺序插入,**避免了页分裂**,因此索引更紧凑 |
5172 | 5351 |
|
5173 | 5352 | * 插入 ID 顺序排列数据: |
5174 | 5353 |
|
@@ -5194,7 +5373,9 @@ LOAD DATA LOCAL INFILE = '/home/seazean/sql1.log' INTO TABLE `tb_user_1` FIELD T |
5194 | 5373 |
|
5195 | 5374 |
|
5196 | 5375 |
|
5197 | | -#### ORDER BY |
| 5376 | +#### 分组排序 |
| 5377 | + |
| 5378 | +##### ORDER |
5198 | 5379 |
|
5199 | 5380 | 数据准备: |
5200 | 5381 |
|
@@ -5271,7 +5452,7 @@ CREATE INDEX idx_emp_age_salary ON emp(age,salary); |
5271 | 5452 |
|
5272 | 5453 |
|
5273 | 5454 |
|
5274 | | -#### GROUP BY |
| 5455 | +##### GROUP |
5275 | 5456 |
|
5276 | 5457 | GROUP BY 也会进行排序操作,与 ORDER BY 相比,GROUP BY 主要只是多了排序之后的分组操作,所以在 GROUP BY 的实现过程中,与 ORDER BY 一样也可以利用到索引 |
5277 | 5458 |
|
@@ -5310,7 +5491,7 @@ GROUP BY 也会进行排序操作,与 ORDER BY 相比,GROUP BY 主要只是 |
5310 | 5491 |
|
5311 | 5492 |
|
5312 | 5493 |
|
5313 | | -#### OR |
| 5494 | +#### 联合查询 |
5314 | 5495 |
|
5315 | 5496 | 对于包含 OR 的查询子句,如果要利用索引,则 OR 之间的**每个条件列都必须用到索引,而且不能使用到条件之间的复合索引**,如果没有索引,则应该考虑增加索引 |
5316 | 5497 |
|
@@ -5353,7 +5534,7 @@ MySQL 4.1 版本之后,开始支持 SQL 的子查询 |
5353 | 5534 |
|
5354 | 5535 | * 可以使用 SELECT 语句来创建一个单列的查询结果,然后把结果作为过滤条件用在另一个查询中 |
5355 | 5536 | * 使用子查询可以一次性的完成逻辑上需要多个步骤才能完成的 SQL 操作,同时也可以避免事务或者表锁死 |
5356 | | -* 在有些情况下,子查询是可以被更高效的连接(JOIN)替代 |
| 5537 | +* 在有些情况下,**子查询是可以被更高效的连接(JOIN)替代** |
5357 | 5538 |
|
5358 | 5539 | 例如查找有角色的所有的用户信息: |
5359 | 5540 |
|
@@ -5701,7 +5882,7 @@ Server 层针对优化**查询**的内存为 Net Buffer,内存的大小是由 |
5701 | 5882 |
|
5702 | 5883 | MySQL 采用的是边读边发的逻辑,因此对于数据量很大的查询来说,不会在 Server 端保存完整的结果集,如果客户端读结果不及时,会堵住 MySQL 的查询过程,但是**不会把内存打爆导致 OOM** |
5703 | 5884 |
|
5704 | | -<img src="https://seazean.oss-cn-beijing.aliyuncs.com/img/MySQL-查询内存优化.png" style="zoom: 50%;" /> |
| 5885 | +<img src="https://seazean.oss-cn-beijing.aliyuncs.com/img/DB/MySQL-查询内存优化.png" style="zoom:50%;" /> |
5705 | 5886 |
|
5706 | 5887 | SHOW PROCESSLIST 获取线程信息后,处于 Sending to client 状态代表服务器端的网络栈写满,等待客户端接收数据 |
5707 | 5888 |
|
@@ -5791,8 +5972,6 @@ MyISAM 存储引擎使用 key_buffer 缓存索引块,加速 MyISAM 索引的 |
5791 | 5972 |
|
5792 | 5973 |
|
5793 | 5974 |
|
5794 | | -说明:本章节知识是抄录自《MySQL 实战 45 讲》,作者目前没有更深的理解,后续有了新的认知后会更新知识 |
5795 | | - |
5796 | 5975 |
|
5797 | 5976 |
|
5798 | 5977 | *** |
@@ -7231,7 +7410,7 @@ SELECT * FROM table_name WHERE ... FOR UPDATE -- 排他锁 |
7231 | 7410 |
|
7232 | 7411 | InnoDB 会对间隙(GAP)进行加锁,就是间隙锁 (RR 隔离级别下才有该锁)。间隙锁之间不存在冲突关系,**多个事务可以同时对一个间隙加锁**,但是间隙锁会阻止往这个间隙中插入一个记录的操作 |
7233 | 7412 |
|
7234 | | -InnoDB 加锁的基本单位是 next-key lock,该锁是行锁和 gap lock 的组合,但是加锁过程是分为间隙锁和行锁两段执行 |
| 7413 | +InnoDB 加锁的基本单位是 next-key lock,该锁是行锁和 gap lock 的组合(X or S 锁),但是加锁过程是分为间隙锁和行锁两段执行 |
7235 | 7414 |
|
7236 | 7415 | * 可以**保护当前记录和前面的间隙**,遵循左开右闭原则,单纯的是间隙锁左开右开 |
7237 | 7416 | * 假设有 10、11、13,那么可能的间隙锁包括:(负无穷,10]、(10,11]、(11,13]、(13,正无穷) |
|